Todas las listas de «visibilidad en IA» del último año dicen que añadas un archivo llms.txt. Los registros de servidor dicen que casi nadie lo lee. Las dos cosas son ciertas, y aun así yo publico uno en esta web. Esto es lo que es, lo que muestran los datos y por qué creo que merece diez minutos, pero no una estrategia.
Qué es el llms.txt
Es un archivo de texto en markdown que se sirve desde la raíz del dominio, en /llms.txt. Lo propuso Jeremy Howard el 3 de septiembre de 2024 como forma de dar a los modelos de lenguaje un mapa breve y seleccionado de una web, en lugar de obligarlos a atravesar menús, scripts y avisos de cookies.
El formato es deliberadamente flexible. Según la propuesta, solo el primero de estos elementos es obligatorio:
- Un H1 con el nombre del sitio o del proyecto. Es lo único obligatorio.
- Una cita (blockquote) con un resumen breve de lo esencial.
- Texto o listas sin encabezados, para el detalle.
- Secciones bajo H2 con listas de enlaces, cada uno con una nota opcional.
- Una sección llamada «Optional», por convención, para lo secundario.
Un archivo mínimo sería así. La sección «Optional» se deja con su nombre en inglés, porque la propuesta la define con ese nombre:
# Ejemplo Consultoría

> Consultoría independiente para marcas que venden en varios países.

## Servicios

- [SEO internacional](https://example.com/es/seo/): hreflang, estructura
- [Auditoría](https://example.com/es/auditoria/): cinco módulos

## Optional

- [Notas](https://example.com/es/notas/): artículos largos
Dos cosas que no es. No es un robots.txt: no permite ni bloquea nada, y un rastreador que lo ignora no pierde nada. No es un sitemap: el sitemap intenta listarlo todo, y el llms.txt es una selección editorial.
Qué dicen los datos
Es la parte que casi todos los artículos sobre llms.txt se saltan, así que es la que merece leerse despacio.
Google, junio de 2025 y junio de 2026
John Mueller, de Google, escribió en Bluesky el 17 de junio de 2025: «FWIW no AI system currently uses llms.txt», es decir, que ningún sistema de IA usa el llms.txt. Añadió que los chatbots sí descargan las páginas, para entrenar y para fundamentar sus respuestas, pero que ninguno descarga el llms.txt, y que cualquiera puede comprobarlo en sus registros de servidor.
La documentación de Google ya lo dice por escrito. Su guía para optimizar un sitio para las funciones de IA generativa de la Búsqueda pone los archivos llms.txt en primer lugar entre lo que se puede ignorar, porque la propia Búsqueda de Google no los utiliza, y el 15 de junio de 2026 Google añadió una nota: crear uno «no perjudicará ni beneficiará a la visibilidad ni al posicionamiento de tu sitio en la Búsqueda de Google, ya que la Búsqueda de Google los ignora por completo». Mantenerlo para otros servicios que sí lo usen, añade la nota, no supone ningún problema.
137.210 dominios, mayo de 2026
Ahrefs lo comprobó a gran escala con los registros de servidor de 137.210 dominios en mayo de 2026. El 28 % —38.360 sitios— tenía un llms.txt válido. El 97 % de esos archivos no recibió ni una sola petición en todo el mes. Y ningún bot de IA pidió el archivo en una web que no lo tuviera: nadie sale a buscarlo.
83 sitios, doce semanas, 2026
La prueba más detallada que he visto es la de EZY Research: 83 sitios con llms.txt, monitorizados durante doce semanas entre el 27 de abril y el 19 de julio de 2026. El rastreador de Meta pidió el archivo 193 veces; Googlebot, 67; ClaudeBot, 9; GPTBot, 7; Perplexity, ninguna. Hubo además 1.001 peticiones de bots que no se pudieron verificar.
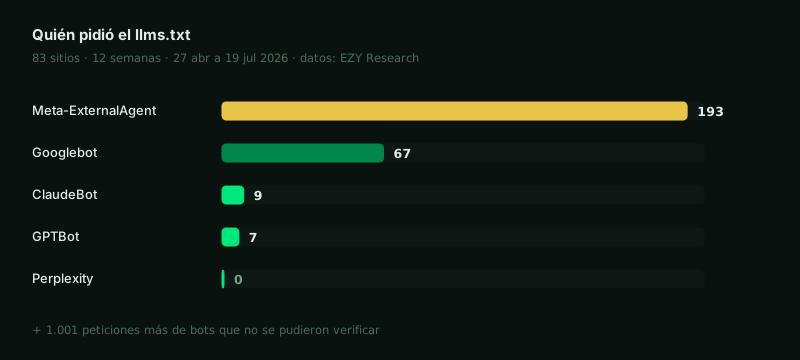
Que un archivo se descargue no significa que se use. Googlebot descarga casi todo lo que encuentra, y la guía de Google lo aclara: que rastree un archivo no significa que lo trate de forma especial. Para la Búsqueda de Google, la cuestión ya está respondida por escrito. Para todo lo demás, no he visto ninguna evidencia publicada que relacione el llms.txt con más citas, más tráfico desde la IA o mejores posiciones.
El llms.txt es una propuesta razonable que, de momento, los sistemas que más importan apenas han adoptado. Trátalo como una apuesta barata y especulativa, no como una táctica.
Por qué publico uno igualmente
- Cuesta casi nada. Solo cambia cuando cambian los servicios o el posicionamiento, que es rara vez.
- Algunos lo piden. El rastreador de Meta es el que más lo solicita en los datos de EZY, y los agentes a los que una persona dirige a una web también lo piden: en el recuento de Ahrefs, un agente de programación lo solicitó más que cualquier bot de búsqueda con IA.
- Escribirlo obliga a ordenar los hechos. Reunir todo lo esencial de un negocio en un único documento destapa contradicciones entre páginas que nadie había visto, y esa coherencia pesa en la visibilidad en IA mucho más que el archivo.
El archivo de esta web se puede leer aquí. Tiene el cuerpo en inglés y una sección en español que enlaza a las páginas en español: un solo archivo, no dos. Es una decisión mía, porque hoy ningún rastreador da motivos para preferir una opción u otra.
Si lo escribes, escríbelo así
- Una ficha de datos, no una copia de la web. Quién eres, qué vendes, cuánto cuesta, para quién es, y enlaces a las páginas que lo demuestran.
- Cada dato tiene que coincidir con su página. Un precio distinto en el llms.txt y en la página del servicio es una contradicción publicada. Yo cambio los dos en el mismo commit.
- Enlaza, no copies. El archivo tiene que apuntar a las páginas, no duplicarlas.
- No digas nada que no digan tus páginas. Contarles a las máquinas algo distinto de lo que ven las personas sigue la lógica del cloaking, y es la forma más rápida de que una fuente seleccionada deje de ser fiable.
Si lo que buscas es aparecer en las respuestas de ChatGPT, lo que decide es otra cosa, y lo explico en SEO para ChatGPT.
Fuentes
- Jeremy Howard, The /llms.txt file, propuesta publicada el 3 de septiembre de 2024.
- John Mueller en Bluesky, 17 de junio de 2025, recogido por Search Engine Roundtable el 18 de junio de 2025.
- Google Search Central, Optimizar tu sitio web para las funciones de IA generativa en la Búsqueda de Google, con la nota sobre llms.txt fechada el 15 de junio de 2026 en el registro de cambios de la documentación (en inglés).
- Louise Linehan, We analyzed 137K sites: 97% of llms.txt files never get read, Ahrefs, 15 de junio de 2026.
- EZY Research, We put llms.txt on 83 websites. OpenAI read it 7 times, 27 de julio de 2026.